Konzepte digitaler Audiosignale
Die digitale Darstellung von Audio umfasst mehrere Schritte und Verfahren. Sowohl für die rohen Audiodaten als auch für das codierte oder komprimierte Audio, das im Web verwendet wird, stehen verschiedene Formate zur Verfügung. Dieser Leitfaden gibt einen Überblick darüber, wie Audio digital dargestellt wird und wie Codecs Audio für die Verwendung im Web codieren und decodieren.
Die Schallwelle
Schall ist von Natur aus ein analoges Phänomen. Wenn ein schallerzeugendes Objekt – beispielsweise Ihre Stimmlippen oder eine Lautsprechermembran – schwingt, versetzt es die umgebenden Moleküle in Schwingung. Diese beeinflussen wiederum die benachbarten Moleküle und so weiter. Dadurch breitet sich die Schwingung als Welle von der Quelle nach außen aus.
Die schwingenden Moleküle bilden das Medium, durch das sich der Schall ausbreitet. Das kann ein Gas, eine Flüssigkeit oder ein Feststoff sein. Alltagsgeräusche breiten sich fast immer durch Luft aus, bevor sie Ihr Ohr erreichen. Knochenleitungskopfhörer hingegen nutzen im Wesentlichen Ihre Knochen – also einen Feststoff – als Medium.
Die Energie der Schallquelle nimmt auf zwei Arten ab. Stellen Sie sich die Schallwelle wie eine Welle vor, die sich auf einer Wasseroberfläche ausbreitet. Während sich ihr Umfang vergrößert, geraten immer mehr Moleküle in Schwingung; jedes einzelne erhält daher weniger von der verfügbaren Bewegungsenergie. Außerdem nimmt jedes Molekül einen Teil der empfangenen Energie als Wärme auf, statt sie weiterzugeben. In einer gewissen Entfernung von der Quelle ist die verbleibende Energie schließlich so gering, dass sich der Schall nicht mehr von Hintergrundgeräuschen unterscheiden lässt. Ein kleiner Teil der Wellenenergie kann jedoch das Ohr einer hörenden Person erreichen, solange der Schall noch wahrnehmbar ist. Das Innenohr nimmt die Welle auf und wandelt sie in elektrische Signale um, die an das Gehirn gesendet werden.
Die Schallwelle selbst ist das Muster der Hin- und Herbewegung (Schwingung) jedes Moleküls im Medium. Dieses Signal verarbeitet Ihr Gehirn. Die folgende Abbildung zeigt beispielsweise die einfachste Schallwelle:
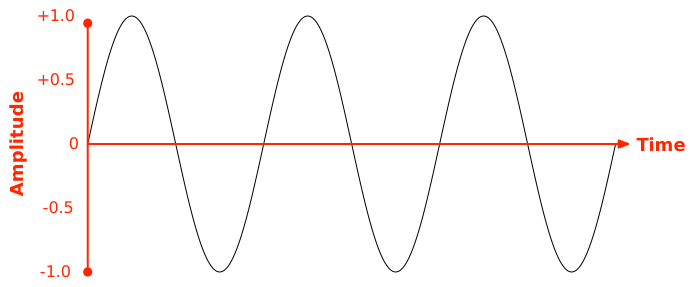
Dies ist eine Sinuswelle mit zwei wichtigen Parametern: der Auslenkung jedes Wellenbergs vom Mittelpunkt, der Amplitude (gemessen in Längeneinheiten wie Metern), und dem Abstand zwischen zwei Wellenbergen, der Periodendauer (gemessen in Zeiteinheiten wie Sekunden). Der Kehrwert der Periodendauer ist die Frequenz: Sie gibt an, wie viele Wellenberge pro Sekunde auftreten, und wird in Hertz gemessen.
Die Amplitude hängt mit der Lautstärke zusammen: Je stärker die Moleküle schwingen, desto lauter ist der Schall in diesem Moment. Die Frequenz hängt mit der Tonhöhe zusammen: Je schneller die Moleküle schwingen, desto höher ist der Ton.
Reale Schallwellen sind nicht so einfach aufgebaut. Hier sehen Sie eine komplexere Schallwelle:
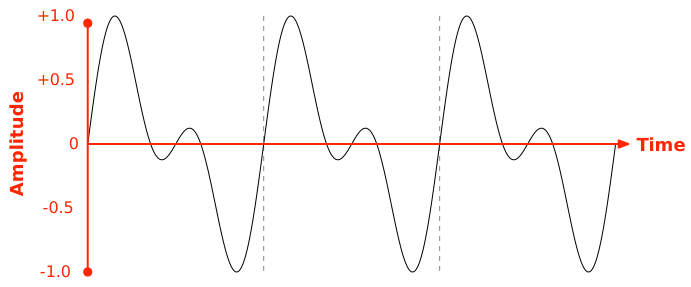
Dieses Signal ist weiterhin periodisch: Es gibt wiederkehrende Muster. Jedes Muster besteht jedoch aus mehr als einem Wellenberg, und die Wellenberge haben unterschiedliche Amplituden. Das Fourier-Theorem besagt, dass sich jede periodische Welle als Summe vieler Sinuswellen ausdrücken lässt. So können wir diese komplexe Welle beispielsweise in ihre Sinuswellen zerlegen:
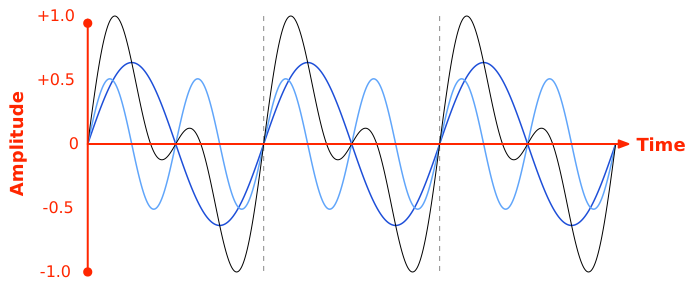
Jede blaue Kurve ist eine Sinuswelle. Addieren Sie die Auslenkungen der blauen Kurven zu jedem Zeitpunkt, erhalten Sie die schwarze Kurve.
Trägt man die Amplitude jeder Sinuswelle gegen ihre Frequenz auf, erhält man das Spektrum des Audiosignals. Die beiden Sinuswellen oben haben beispielsweise die Frequenzen f0 und 2f0. Die erste hat eine etwas größere Amplitude als die zweite. Das Spektrum sieht daher so aus:
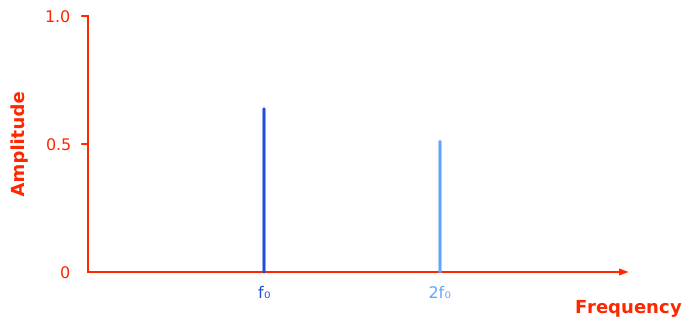
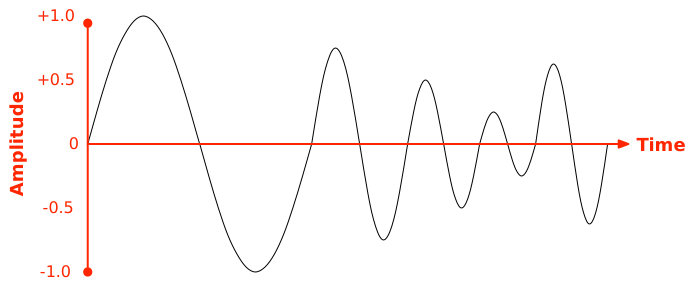
Dieses Schallsignal hat zwei Frequenzkomponenten: eine mit der Frequenz f0 und eine weitere mit der Frequenz 2f0. Die gesamte Energie konzentriert sich auf diese beiden Frequenzen; alle anderen Frequenzen haben keine Energie. Bei realen Schallsignalen verteilt sich die Energie gewöhnlich über zusammenhängende Frequenzbereiche. Wir können daher beispielsweise sagen, dass ein Schall ein Frequenzband aufweist. Im Zeitbereich könnte ein solches Signal so aussehen:
Audio abtasten
Schall ist ein analoges Signal. Bei der oben gezeigten Schallwelle kann sich jeder einzelne Punkt der Kurve entlang der Zeit- und Auslenkungsachsen kontinuierlich verändern. Computer arbeiten dagegen digital und müssen eine Welle durch eine begrenzte Anzahl einzelner Datenpunkte darstellen. Dieses Verfahren heißt Analog-Digital-Umwandlung (kurz A/D).
Ähnlich wie das menschliche Ohr ist auch das Mikrofon ein analoges Gerät. Es wandelt die Schallwelle in elektrische Signale um, deren Spannungspegel die Amplitude darstellen. Dieses analoge Signal wird an eine Schaltung gesendet, die A/D-Wandler oder ADC genannt wird. Sie erfasst den Spannungspegel in regelmäßigen Zeitabständen – der Abtastperiode – und speichert ihn als Zahl mit fester Bitbreite. So wird aus der kontinuierlichen Welle ein diskretes Array von Amplitudenwerten. Jeder erfasste Moment ist ein Sample. Nimmt man an, dass die Schallwelle von einem Sample zum nächsten sprunghaft wechselt, erhält man die unten dargestellte treppenförmige Näherung.
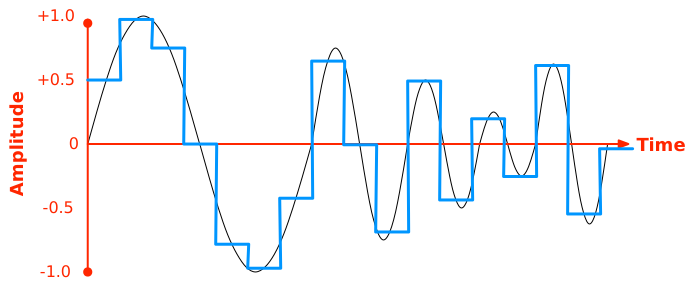
In diesem Beispiel ist die schwarze Kurve die ursprüngliche analoge Audiowellenform und die blaue Kurve die angenäherte digitale Welle. Die Mitte jedes waagerechten Abschnitts der blauen Kurve ist ein tatsächliches Sample; dort schneidet der Abschnitt auch die schwarze Kurve. Wir verlängern jedes Sample nach links und rechts um jeweils eine halbe Abtastperiode und verbinden die waagerechten Abschnitte zum Treppenmuster.
Bei der späteren Wiedergabe werden diese Amplituden mithilfe eines Rekonstruktionsfilters verwendet, um eine kontinuierliche Näherung der ursprünglichen Wellenform zu erzeugen. Treppenförmige Wellen klingen im Allgemeinen unangenehm. Moderne Geräte verwenden Filter, um die Glätte der Wellenform so weit wie möglich wiederherzustellen.
Der ADC selbst hat mehrere Parameter, die entweder durch die Hardware festgelegt oder einstellbar sind. Der erste ist die Abtastrate, also die Anzahl der Samples pro Sekunde. Sie ist der Kehrwert der Abtastperiode: Je weiter zwei Samples zeitlich auseinanderliegen, desto weniger Samples werden pro Sekunde erfasst. Auf Abtastraten gehen wir unter Audio-Codecs näher ein, da sie auch durch den Codec angepasst werden können.
Der zweite Parameter ist die Audiobandbreite. Sie bestimmt die höchste Frequenz, die der ADC erfassen kann. Auch der Codec kann die Bandbreite begrenzen. (Darauf gehen wir unter Abtastraten ebenfalls näher ein.)
Der dritte Parameter ist die Verstärkung (Gain). Sie bestimmt näherungsweise, wie die Eingangsamplitude auf Spannungspegel abgebildet wird. Eine höhere Verstärkung lässt das Audio lauter klingen. Sie kann aber auch Spannungspegel erzeugen, die außerhalb des von der Hardware unterstützten Bereichs liegen. Solche Werte werden auf den unterstützten Bereich begrenzt, wodurch die Wellenform verfälscht wird.
Der vierte Parameter ist die Auflösung: die Anzahl der Bits, mit denen jedes Amplituden-Sample codiert wird. Bei 8-Bit-Samples kann das digitale Signal beispielsweise 28 = 256 verschiedene Amplitudenwerte unterscheiden. Das ergibt kleine Dateien, aber auch Audio von sehr geringer Qualität. Heute wird „8-Bit“ nur noch selten als tatsächliche Audioauflösung verwendet; der Ausdruck beschreibt vielmehr eine Retro-Klangästhetik, ähnlich wie Pixel-Art.
Die Auflösung setzt die Obergrenze für die Audioqualität. Sie können mit einer höheren Sample-Größe beginnen und diese später verringern. Sie können aber beispielsweise kein Audio in 16-Bit-Qualität erzeugen, wenn Ihr ADC nur eine 8-Bit-Auflösung hat.
Hinweis: Wie die meisten anderen Bereiche moderner Technik ist auch die Audioaufnahme heute wesentlich komplexer, als diese Einführung vermuten lässt. Moderne ADCs können beispielsweise mit einer höheren Abtastrate arbeiten und das Signal anschließend algorithmisch durch lokale Mittelwertbildung statt durch Momentanmessungen auf die gewünschte Abtastrate umrechnen. Als grundlegendes Denkmodell ist dieser Abschnitt dennoch hilfreich.
Format und Struktur von Audiodaten
Der ADC gibt ein Array von Zahlen aus. Speichert man diese unverändert in einer Datei, erhält man PCM-Audio (Pulse-Code-Modulation). Die meisten Audio-Codecs sind jedoch komplexer. Möglicherweise benötigen Sie beispielsweise Komprimierung, mehrere Kanäle oder sogar eine Möglichkeit, Daten wiederherzustellen, falls ein Teil verloren geht. Die Software, die das rohe ADC-Signal für Softwarezwecke in komplexere Formate umwandelt, heißt Audio-Codec (COder/DEcoder). Im Laufe der Jahre wurden viele Codecs entwickelt; einige davon werden häufig im Web verwendet. Einzelheiten zu den wichtigsten Codecs für die Webentwicklung finden Sie im Artikel Leitfaden zu im Web verwendeten Audio-Codecs.
Audiokanäle und Frames
Moderne Audio-Codecs unterstützen mehrere Kanäle. Das bedeutet, dass sie mehrere zeitlich aufeinander abgestimmte, parallele Audiosignale speichern können. Wenn Sie beispielsweise Musik über Kopfhörer hören, können Ihr linkes und Ihr rechtes Ohr unterschiedliche Klänge wahrnehmen. Das liegt daran, dass diese in getrennten Kanälen gespeichert sind. Wenn ein einzelnes Signal ein Array von Zahlen ist, dann ist Mehrkanal-Audio im Wesentlichen ein Array von Audio-Frames. Jeder Frame ist ein Array aus n Zahlen, wobei n die Anzahl der Kanäle ist.
Hinweis: Manche Codecs trennen den linken und den rechten Kanal tatsächlich und speichern sie in verschiedenen Blöcken ihrer Datenstruktur. Ein Audio-Frame umfasst jedoch immer sämtliche Daten aller verfügbaren Kanäle. Die Samples können von Software zusammengestellt werden, statt im Codec physisch nebeneinander gespeichert zu sein.
Es gibt zwei Arten von Audiokanälen. Standard-Audiokanäle übertragen den Großteil des hörbaren Schalls. Die Signale für den linken und rechten Hauptkanal sowie für Ihre Surround-Lautsprecher – etwa Center-, hintere linke und rechte, seitliche linke und rechte oder Deckenkanäle – sind allesamt Standard-Audiokanäle. Spezielle Low-Frequency-Effects-Kanäle (LFE) liefern das Signal für Lautsprecher, die tieffrequente Klänge und Vibrationen erzeugen und beim Hören ein körperlich spürbares Erlebnis vermitteln sollen. LFE-Kanäle steuern normalerweise Subwoofer und ähnliche Geräte an.
Monophones Audio hat einen Kanal, Stereoton zwei Kanäle und 5.1-Surround-Sound sechs Kanäle (fünf Standardkanäle und einen LFE-Kanal). Jeder Audio-Frame ist ein Datensatz mit den Samples für alle Kanäle eines Audiosignals.
Samples
Der ADC gibt Ganzzahlen mit einer bestimmten Auflösung aus. Der Codec wandelt sie anschließend in einen Datentyp um, der eine bestimmte Sample-Größe darstellt. Die meisten Audiodateien verwenden vorzeichenbehaftete 16-Bit-Ganzzahlen für jedes Sample. Andere verwenden 32-Bit-Gleitkommawerte oder 24-Bit- beziehungsweise 32-Bit-Ganzzahlen. Samples können vorzeichenbehaftet oder vorzeichenlos sein.
Abtastraten
Wir haben Abtastraten bereits im Zusammenhang mit ADCs besprochen. Auch die Codecs selbst können Audio neu abtasten. Die gebräuchlichsten Abtastraten sind:
- 8000 Hz
-
Der internationale Standard G.711 für Audio in der Telefonie verwendet eine Abtastrate von 8000 Hz (8 kHz). Das reicht aus, um menschliche Sprache verständlich wiederzugeben.
- 44100 Hz
-
Die Abtastrate von 44,1 kHz wird für Audio auf Compact Discs (CDs) verwendet. CDs bieten unkomprimierten 16-Bit-Stereoton mit 44,1 kHz. Auch Computer-Audio verwendet häufig standardmäßig diese Abtastrate.
- 48000 Hz
-
Audio auf DVDs wird mit 48 kHz aufgezeichnet. Diese Abtastrate wird ebenfalls häufig für Computer-Audio verwendet.
- 96000 Hz
-
Hochauflösendes Audio.
- 192000 Hz
-
Audio mit extrem hoher Auflösung. Es wird bislang selten verwendet, doch das kann sich im Laufe der Zeit ändern.
Eine niedrige Abtastrate erzeugt weniger Daten. Sie kann jedoch dazu führen, dass schnelle Schwingungen zwischen den Samples fälschlich als Signal mit niedrigerer Frequenz interpretiert werden. Dieses Phänomen heißt Aliasing. Betrachten Sie beispielsweise noch einmal das ursprüngliche Sinuswellen-Diagramm und nehmen Sie Samples wie hier:
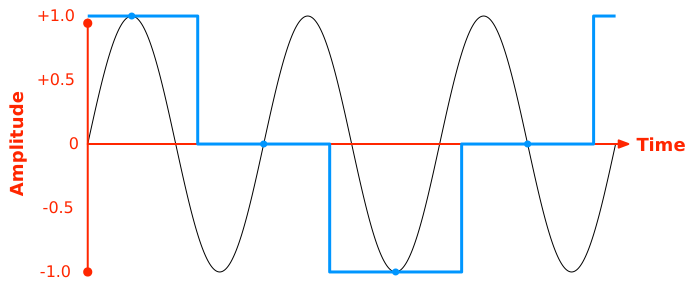
Innerhalb einer Periode der blauen Treppennäherung liegen nun drei Perioden der ursprünglichen Welle. Die blaue Welle hat daher nur ein Drittel der Frequenz des ursprünglichen Signals. Wenn Sie die blaue Welle abspielen, hören Sie einen deutlich tieferen Ton als bei der ursprünglichen schwarzen Welle!
Das Nyquist-Shannon-Abtasttheorem besagt: Um Signale, deren Komponenten bis zur Frequenz f reichen, originalgetreu zu rekonstruieren, muss die Abtastrate mehr als doppelt so hoch sein (2f). Umgekehrt wird die Hälfte einer gegebenen Abtastfrequenz als Nyquist-Frequenz bezeichnet. Sie ist die Obergrenze für Frequenzen im Audiospektrum, die originalgetreu erfasst werden können. Die Abtastrate, die Sie für den Codec wählen, muss daher eine Nyquist-Frequenz ergeben, die über der höchsten erwarteten Aufnahmefrequenz liegt.
In der Praxis enthält das Eingangssignal fast immer Frequenzbänder oberhalb der Nyquist-Frequenz. Wird ein solches Signal ohne weitere Verarbeitung abgetastet, erscheinen hochfrequente Komponenten durch Aliasing als niederfrequente Komponenten. Ihre Wellenauslenkungen werden addiert und verfälschen die niederfrequenten Komponenten. Um dies zu verhindern, durchläuft das Signal vor der Abtastung – entweder im ADC oder im Audio-Encoder – zunächst einen Tiefpassfilter. Der Tiefpassfilter multipliziert die Amplitude jeder Frequenz im Spektrum mit einem Wert zwischen 0 und 1. Ein Faktor von 1 erhält die Energie, ein Faktor von 0 entfernt die Komponente vollständig, und andere Werte schwächen sie ab, ohne sie zu entfernen. Idealerweise wäre der Tiefpassfilter ein „Brick-Wall-Filter“, der Frequenzen unterhalb der Nyquist-Frequenz vollständig erhält und Frequenzen oberhalb davon vollständig entfernt. Das lässt sich in Hardware jedoch nicht umsetzen. Tatsächliche Tiefpassfilter haben deshalb ein Übergangsband, in dem Frequenzen abgeschwächt, aber nicht entfernt werden.

Wenn Sie beispielsweise eine Nyquist-Frequenz von 20 kHz wünschen – entsprechend einer Abtastrate von 40 kHz –, sollten Sie sicherstellen, dass der Filterwert bei 20 kHz nahe genug an 0 liegt. Ist das Übergangsband 2 kHz breit, können Sie nur erwarten, dass Frequenzen bis 18 kHz ausreichend erhalten bleiben. Frequenzen zwischen 18 kHz und 20 kHz werden abgeschwächt und verlieren an Amplitude.
Das erklärt die oben aufgeführten gebräuchlichen Abtastraten:
- Herkömmliches Telefonaudio überträgt Frequenzen bis etwa 3.400 Hz und erhält damit genügend Informationen, damit Sprache verständlich bleibt. (Dabei gehen sehr viele Informationen verloren, weshalb eine „Telefonstimme“ häufig dünn und dumpf klingt.) Die Abtastrate von 8.000 Hz ergibt eine Nyquist-Frequenz von 4.000 Hz und lässt 600 Hz für das Übergangsband.
- Menschen können Schall bis zu 20.000 Hz hören. Die Abtastraten von 44,1 kHz und 48 kHz ergeben jeweils Nyquist-Frequenzen, die etwas darüber liegen. Damit bleiben 2,05 kHz beziehungsweise 4 kHz für das Übergangsband. 48 kHz erzeugt etwas mehr Daten, ermöglicht aber ein breiteres Übergangsband, wodurch hochfrequente Klänge möglicherweise besser erhalten bleiben.
- 96 kHz und 192 kHz sind für die Rekonstruktion von Klängen, die Menschen bewusst wahrnehmen können, technisch nicht notwendig. Sie bieten jedoch noch mehr Spielraum für Filter und erhalten Komponenten, die beim Verlangsamen hörbar werden können. Üblicherweise werden sie beim Audio-Mastering verwendet: Dort ist möglichst hohe Qualität erforderlich, während der Klang bearbeitet wird, bevor er auf die Abtastrate des Endprodukts heruntergerechnet wird. Das ist vergleichbar mit der Arbeit von Fotografinnen und Fotografen, die Bilder mit hoher Auflösung bearbeiten und zusammensetzen, bevor sie ihren Kundinnen und Kunden ein für eine Website geeignetes JPEG bereitstellen.
Audiodateigröße und Netzwerkbandbreite
Im Web ist die häufigste Konfiguration Stereo (2 Kanäle: links und rechts), 16-Bit-Samples (2 Byte) und eine Abtastrate von 48 kHz. Multipliziert man diese Werte, erhält man die pro Sekunde übertragenen Daten – die Bitrate:
Bei 192 kBps kann schon ein einzelner Audiostream langsamere Netzwerkverbindungen stark belasten. Wenn das Netzwerk gleichzeitig andere Aufgaben erfüllt, kann selbst bei schnelleren Verbindungen die Bandbreite knapp werden. Da viele Anwendungen um Netzwerkkapazität konkurrieren – besonders in langsameren Netzwerken –, kann diese Datenmenge für eine praktikable Echtzeitübertragung zu groß sein.
Hinweis: Die Netzwerkbandbreite (Byte pro Sekunde) ist nicht dasselbe wie die Audiobandbreite (höchste aufgezeichnete Frequenz), die oben unter Audio abtasten behandelt wird.
Multipliziert man die Bitrate mit der Dauer, erhält man die Größe der rohen Audiodaten. Ein dreiminütiges Lied benötigt beispielsweise unkomprimiert 192.000 × 180 = 34,56 MB. Auch das ist für eine Webressource inakzeptabel groß.
Um dieses Problem zu lösen, muss das Audio durch Komprimierung verkleinert werden.
Grundlagen der Audiokomprimierung
Anders als Text und viele andere Datenarten enthalten Audiodaten tendenziell viel Rauschen. Das bedeutet, dass die Daten selten aus Folgen exakt wiederholter Bytes oder Bytefolgen bestehen. Deshalb lassen sich Audiodaten nur schwer mit herkömmlichen Algorithmen komprimieren, wie sie universelle Werkzeuge wie zip verwenden. Diese ersetzen wiederholte Datenfolgen üblicherweise durch eine kürzere Darstellung.
Wenn ein Verlust an Details und möglicherweise an Klangtreue nicht akzeptabel oder unerwünscht ist, sollte ein verlustfreier Codec verwendet werden. Ist eine gewisse Verringerung der Klangtreue dagegen vertretbar, kann ein verlustbehafteter Codec eingesetzt werden. Die meisten Audio-Codecs verwenden verlustbehaftete Komprimierung, weil sie eine bessere Kompressionsrate bietet. Während verlustfreie Komprimierungsalgorithmen gewöhnlich Dateien erzeugen, die 40–50 % der ursprünglichen unkomprimierten Größe haben, können moderne verlustbehaftete Algorithmen je nach Komplexität des Audios Ergebnisse mit 5–20 % der ursprünglichen Größe liefern.
Verlustbehaftete Codecs können Qualität und Details einbüßen. Für durchschnittliche Hörerinnen und Hörer sind diese Verluste jedoch meist schwer zu erkennen, während die bessere Kompressionsrate den Qualitätsverlust bei Weitem aufwiegt. Manche Menschen haben allerdings ein außergewöhnlich gutes Gehör oder erkennen besonders leicht die Veränderungen, die verlustbehaftete Komprimierungsverfahren in Musik verursachen.
Forschende entwickeln fortlaufend bessere Verfahren zur Analyse und Komprimierung von Audio. Daher erscheinen regelmäßig neue Formate, die Verbesserungen bei der Kompressionsrate, der Klangtreue oder beidem bieten.
Zu den Anwendungsfällen für verlustfreies Audio gehören:
- Situationen, in denen hörende Personen eine präzise Klangwiedergabe erwarten und möglicherweise feinste Details unveränderten Audios wahrnehmen können
- Audio-Loops und Samples für die Produktion von Musik und Soundeffekten
- Situationen, in denen Audioclips oder Samples neu abgemischt und anschließend komprimiert werden: Verlustfreies Audio beim Mastering verhindert, dass bereits komprimierte Daten erneut komprimiert werden und dadurch weitere Qualitätsverluste entstehen
Für verlustbehaftete Komprimierung können folgende Faktoren sprechen:
- Sehr umfangreiches Quellaudio
- Begrenzter Speicherplatz – entweder weil wenig Speicher verfügbar ist oder weil sehr viel Audio gespeichert werden muss
- Die Notwendigkeit, die für die Audioübertragung benötigte Netzwerkbandbreite zu begrenzen; das ist besonders für Livestreams und Telefonkonferenzen wichtig
Wenn Sie bereits mit der Auswahl von Bildformaten vertraut sind, werden Ihnen die Überlegungen zur Wahl zwischen verlustbehafteten und verlustfreien Audio-Codecs bekannt vorkommen: Sie ähneln denen für verlustbehaftete und verlustfreie Bildformate wie JPEG und PNG.
Psychoakustik – eine Einführung
Verlustfreie Komprimierung arbeitet rein algorithmisch, ähnlich wie zip. Verlustbehaftete Komprimierung muss dagegen berücksichtigen, wie viele Informationen entfernt werden können, bevor dies für die Zielgruppe hörbar wird. Entfernt man Klangkomponenten, die nicht wirklich wahrgenommen werden, wird die Wellenform einfacher. Dadurch entstehen einheitlichere Daten, die sich leichter komprimieren lassen.
Da Audio meist für Menschen wiedergegeben wird, nutzen die gebräuchlichsten verlustbehafteten Verfahren Erkenntnisse der Psychoakustik. Sie untersucht, wie Menschen Schall wahrnehmen und welche Audiofrequenzen für ihre Wahrnehmung besonders wichtig sind – abhängig von Kontext und Inhalt des Schalls. Ein Codec kann Faktoren wie die Wahrnehmbarkeit von Frequenzänderungen, den gesamten menschlichen Hörbereich oder Amplitudenunterschiede berücksichtigen.
Die Einzelheiten der Psychoakustik und der Audiokomprimierung gehen weit über den Rahmen dieses Artikels hinaus. Ein grundlegendes Verständnis davon, wie gängige Algorithmen Audio komprimieren, kann Ihnen jedoch helfen, Audio-Codecs besser auszuwählen.
Insgesamt können verlustbehaftete Filterverfahren drei Auswirkungen haben:
- Sie können die Audioqualität verbessern. Beispielsweise kann ein Filter Rauschen und Hintergrundgeräusche entfernen, leise Abschnitte in Stille umwandeln und das Signal glätten. So können stille Abschnitte entstehen und wichtige Klänge leichter zu hören sein.
- Sie können die Audioqualität vollständig erhalten, indem sie Signale entfernen, die Menschen nicht wahrnehmen können – beispielsweise Frequenzbänder oberhalb des menschlichen Hörbereichs.
- Sie können relevante Teile des Audios entfernen, die für die übermittelte Information jedoch unerheblich sind – beispielsweise Frequenzbänder oberhalb der für menschliche Sprache typischen Frequenzen.
Die Art des zu codierenden Inhalts kann die Wahl des Codecs beeinflussen. Insbesondere Sprach-Codecs können sich die Struktur menschlicher Sprache zunutze machen. Verständliche Sprache lässt sich außerdem übertragen, ohne den gesamten vom menschlichen Ohr wahrnehmbaren Frequenzbereich zu nutzen.
Eine gängige Komprimierungstechnik ist die Verringerung der Audiobandbreite. Ein schmaleres Frequenzspektrum enthält weniger Informationen, sodass der verlustfreie Komprimierungsalgorithmus effektiver arbeiten kann. Am wirksamsten lässt sich die Bandbreite durch Senken der Höchstfrequenz reduzieren. Eine sichere Obergrenze besteht darin, nur Frequenzbänder unterhalb von 20.000 Hz zu erhalten. Die Nyquist-Frequenzen der meisten Codecs liegen bereits nahe an dieser Grenze. Viel weiter kann man kaum gehen, ohne wahrnehmbare Informationen zu verlieren; dennoch ist dies ein hilfreicher Anfang. Manche Menschen können in gewissem Umfang Frequenzen außerhalb dieses Bereichs hören. Häufiger liegt die obere Hörgrenze allerdings darunter. Insbesondere nimmt die Empfindlichkeit für hohe Frequenzen mit zunehmendem Alter im Allgemeinen ab.
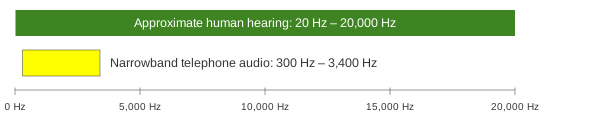
Herkömmliche Schmalband-Telefonsysteme, die speziell für die Übertragung menschlicher Stimmen entwickelt wurden, übertragen Audio von etwa 300 Hz bis 3.400 Hz. Das deckt nicht den gesamten Bereich menschlicher Sprache ab, liefert aber unter vielen Hörbedingungen genügend spektrale und zeitliche Informationen, damit Sprache verständlich bleibt. Für die ressourcensparende Sprachübertragung ist dies daher ein bewährter Kompromiss. Wird das Band noch weiter eingeschränkt, kann Sprache schwerer verständlich werden.
Das folgende Diagramm vergleicht den ungefähren Frequenzbereich des menschlichen Gehörs (grün) mit dem Band herkömmlicher Schmalband-Telefonie (gelb). Wenn Sie die Abtastrate von 48 kHz auf 8 kHz senken, reduzieren Sie die Datenmenge damit bereits vorab ungefähr im Verhältnis 6:1.
Sie können die Frequenzbandbreite auch zwischen diesen beiden Grenzen anpassen, um die gewünschte Kompressionsrate zu erreichen und zugleich genügend Qualität für Ihre Zielgruppe zu erhalten. Beispielsweise empfiehlt Johnson (2012, S. 53, 86) für akustische und phonetische Analysen eine Abtastrate von 22 kHz, da „die menschliche Empfindlichkeit für Frequenzinformationen oberhalb von 10 kHz eher begrenzt ist“.
Verschiedene Merkmale der Sprache liegen in unterschiedlichen Frequenzbereichen, zum Beispiel:
- Manche aperiodischen Konsonanten, etwa Zischlaute wie das zischende „s“, konzentrieren ihre Energie auf hohe Frequenzen zwischen 4 kHz und 10 kHz. Im Telefoniebereich werden sie gewöhnlich als Erstes herausgefiltert. Ihre Entfernung kann die Spracherkennung beeinträchtigen.
- Vokale entstehen durch Verengungen des Vokaltrakts. Dabei werden bestimmte Bereiche des Frequenzspektrums abgeschwächt und andere verstärkt. So entstehen Frequenzbänder mit konzentrierter Energie, die Formanten heißen. Die ersten beiden Formanten reichen gewöhnlich aus, um die meisten Vokale zu unterscheiden; sie können zwischen 200 Hz und 3.000 Hz liegen. Anatomische Faktoren wie die Länge des Vokaltrakts können sie beeinflussen. Diese Faktoren hängen wiederum unter anderem vom Alter und Geschlecht der sprechenden Person ab.
- Die Schwingungsfrequenz der Stimmlippen bestimmt die Tonhöhe beziehungsweise Grundfrequenz der Stimme und trägt Informationen über den Tonfall. Die Grundfrequenz liegt zwischen 80 Hz und 300 Hz und hängt ebenfalls von anatomischen Faktoren ab, die durch Alter und Geschlecht beeinflusst werden. Bei Kindern kann sie bis zu 600 Hz erreichen. Die Grundfrequenz kann für den Telefoniebereich zu niedrig sein; Obertöne höherer Ordnung (Harmonische) helfen dem Gehirn jedoch, die Tonhöhe zu rekonstruieren.
- Manche Sprachmerkmale, etwa Knarrstimme (vocal fry), können Frequenzen von nur 20 Hz erreichen.
Wenn Sie die Audiobandbreite einschränken, sollten Sie daher mit verschiedenen sprechenden Personen – Männern, Frauen, Kindern und älteren Menschen – und unterschiedlichen Lauten testen, ob diese weiterhin erkennbar bleiben.
Neben der Vereinfachung des Klangs durch psychoakustische Analyse verwenden Codecs weitere Algorithmen und Transformationen, um Audio zusätzlich zu vereinfachen und zu verkleinern. Wenn Sie mehr darüber erfahren möchten, wie Audiokomprimierung funktioniert, lesen Sie auf Wikipedia den Abschnitt Komprimierung von Audiodaten.
Wichtig ist: Die Codecs übernehmen die schwierige Arbeit für Sie. Deshalb fließen so viel Entwicklungsarbeit und wissenschaftliche Forschung in neue Algorithmen und Codecs. Sie müssen lediglich die verfügbaren Optionen und Ihren Anwendungsfall berücksichtigen und dann einen geeigneten Codec auswählen.
Hinweis: Einen ausführlicheren Leitfaden zur Auswahl von Audio-Codecs finden Sie unter Einen Audio-Codec auswählen.
Parameter verlustfreier Encoder
Verlustfreie Encoder haben weniger Möglichkeiten, das Audio zugunsten einer besseren Kompressionsrate zu verändern, da sie das ursprüngliche Audio wiedergeben müssen. Dadurch ist die Zahl der konfigurierbaren Optionen begrenzt. Diese betreffen meist die Wahl des Codierungsverfahrens sowie die Zeit und Rechenleistung, die der Encoder dafür aufwenden darf.
Die Parameter unterscheiden sich je nach Codec, können aber Folgendes umfassen:
- Algorithmen, die in bestimmten Phasen des Codierungsprozesses verwendet werden
- Parameter für diese Algorithmen, etwa die bei der Modellierung des Audios verwendete Vorhersagetiefe
- Die Anzahl der Durchläufe bei der Analyse des Audios oder die Anzahl der Ausführungen bestimmter Algorithmen
Parameter verlustbehafteter Encoder
Die meisten Codecs bieten Eingabewerte, mit denen Sie die Komprimierung auf unterschiedliche Weise optimieren können – entweder zugunsten der Dateigröße oder der Qualität. Bei einem verlustbehafteten Encoder wird das codierte Audio mit steigender Qualität größer. Deshalb beeinflussen die meisten Optionen sowohl die Qualität als auch die Größe.
Welche Optionen verfügbar sind, entnehmen Sie der Dokumentation Ihrer Codierungssoftware. Bei manchen Codecs können Sie mehrere Werte anpassen; einige davon erfordern möglicherweise ein tiefes Verständnis der Psychoakustik und der Algorithmen des Codecs. Andere bieten einen Parameter für die „Qualität“, der verschiedene Eigenschaften des Algorithmus automatisch anpasst.
Bitrate
Es gibt zwei sich gegenseitig ausschließende Möglichkeiten, die Qualität komprimierten Audios über die Bitrate zu steuern. Bei der ersten wird eine durchschnittliche Bitrate für die codierten Daten angestrebt. Bei der zweiten wird ein konstanter Zielwert für die Qualität vorgegeben, während die Bitrate variieren darf.
Durchschnittliche Bitrate
Die erste Methode zur Steuerung der Qualität der Ausgabedatei besteht darin, bei der Audiocodierung eine durchschnittliche Bitrate (ABR, Average Bit Rate) als Ziel vorzugeben. Der Encoder versucht dann, eine codierte Audiodatei zu erzeugen, die im Durchschnitt die angegebene Anzahl von Bits pro Sekunde Wiedergabezeit verwendet. Damit wird die Qualität über die Größe des codierten Audios gesteuert: Je höher die Bitrate, desto höher ist die resultierende Audioqualität. Die Audioqualität schwankt im Verlauf der Aufnahme nach Bedarf, um die angestrebte Bitrate zu erreichen.
Ein ähnliches Verfahren ist CBR (Constant Bit Rate, konstante Bitrate). Während ABR versucht, die Bitrate im Durchschnitt auf einem bestimmten Niveau zu halten und gewisse Schwankungen zulässt, verwendet CBR über die gesamte Dauer des Audios eine tatsächlich feste Bitrate. CBR wird vor allem in Codecs eingesetzt, die ausschließlich für Sprache entwickelt wurden. Dort sind Frequenzbereich und Schwankungen tendenziell gering, sodass CBR ohne unpraktikable Schwankungen der Audioqualität funktioniert.
Variable Bitrate
Die Codierung mit variabler Bitrate (VBR, Variable Bit Rate) verwendet eine Einstellung für konstante Qualität als Eingabe. Sie gibt das Qualitätsniveau vor, das während der gesamten Audiodauer erhalten bleiben soll. Die Bitrate darf nach Bedarf schwanken, um dieses Niveau zu erreichen. In Abschnitten, die sich mit minimalen Qualitätseinbußen leicht komprimieren lassen, kann die Bitrate sehr niedrig sein. Wo die Komprimierung schwieriger ist, steigt sie.
Audiofrequenzbandbreite
Bei manchen Codecs können Sie die Audiofrequenzbandbreite direkt konfigurieren: durch Angabe des zulässigen Frequenzbereichs, durch Festlegen einer oberen und/oder unteren Frequenzgrenze oder durch Auswahl eines Audioquelltyps. Letzterer bestimmt, wie der Algorithmus entsprechend der erwarteten Frequenzen des Eingangssignals konfiguriert wird.
Einige Codecs unterstützen außerdem spezielle Kanäle mit begrenzter Frequenzbandbreite, etwa den LFE-Kanal. Bei LFE ist die Audiofrequenzbandbreite auf einen Bereich beschränkt, der sich für einen Subwoofer oder ein ähnliches Gerät zur Klangverbesserung eignet.
Manche Codecs bieten spezielle Profile für bestimmte Anwendungsfälle wie VoIP. Diese Profile können standardmäßig auch Einschränkungen der Audiofrequenzbandbreite enthalten.
Joint Stereo
Stereoton wird üblicherweise durch Audio-Frames mit einem Sample pro Kanal dargestellt. Jeder Audio-Frame benötigt damit 2 mal sampleSize Bits, wobei sampleSize die Anzahl der Bits pro Audio-Sample ist. Bei einer 16-Bit-Stereoaufnahme benötigt jeder Frame somit 2 mal 16, also 32 Bit. Dies ist herkömmliches Links-rechts-Stereo (L/R) oder einfaches Stereo.
Joint Stereo ist eine platzsparendere Methode zur Speicherung von Stereo-Audio-Samples. Sie nutzt aus, dass der Schall, der die beiden Ohren erreicht, normalerweise ähnlich ist. Statt sämtliche Bits jedes Kanal-Samples zu speichern, werden eine gemeinsame Grundamplitude und ein Wert für die Amplitudenabweichung je Kanal gespeichert. Für den Abweichungswert sind möglicherweise weniger Bits erforderlich als für ein vollständiges Sample.
Es gibt zwei Arten von Joint Stereo: Mid-Side und Intensity. Der Encoder kann während einer Audiodatei zwischen diesen Darstellungsformen des Stereosignals wechseln.
Mid-Side-Stereocodierung
Bei der Mid-Side-Stereocodierung (MS) werden Frames mit einem grundlegenden Mid-Kanal aufgezeichnet. Dieser enthält die durchschnittliche Amplitude des ursprünglichen linken und rechten Audiokanals. Das entspricht im Wesentlichen der Amplitude, die Sie beim Umwandeln eines Stereosignals in Mono berechnen würden. Zusätzlich wird der Wert des Side-Kanals gespeichert. Dieser wird zum Wert des Mid-Kanals addiert, um die ursprüngliche Amplitude des linken Kanals zu bestimmen, und davon subtrahiert, um den ursprünglichen Wert des rechten Kanals zu berechnen.
Für einen linken Kanal L und einen rechten Kanal R führen Sie beim Codieren eines Samples also folgende Berechnungen durch:
Anschließend speichern Sie die Werte von mid und side. mid benötigt weiterhin die volle Sample-Größe, beispielsweise 16 Bit. side lässt sich wahrscheinlich mit weniger Bits speichern, da die Amplituden der beiden Kanäle relativ ähnlich sind. Der Encoder kann die dadurch verringerte Gesamtzahl von Bits pro Frame nutzen und weitere Berechnungen durchführen, um die Größe zusätzlich zu reduzieren.
Beim Decodieren des Audios werden die absoluten Werte für den linken und rechten Kanal so berechnet:
Für sich genommen ist die Mid-Side-Stereocodierung verlustfrei. Sie wird häufig sowohl von verlustfreien als auch von verlustbehafteten Audio-Codecs verwendet. Etwaige Detailverluste entstehen in anderen Schritten des Codierungsprozesses.
Intensity-Stereocodierung
Die Intensity-Stereocodierung senkt die Bitrate des codierten Audios, indem sie sich zunutze macht, wie Menschen die Position von Schall im Raum bestimmen. Dies wird Schalllokalisation genannt.
Unsere Ohren befinden sich auf gegenüberliegenden Seiten des Kopfes und sind daher mehrere Zentimeter voneinander entfernt. Ein Schall von rechts erreicht das rechte Ohr vor dem linken; auch die an beiden Ohren wahrgenommenen Amplituden unterscheiden sich. Unser Gehirn nutzt diese Phasen- und Amplitudenunterschiede, um die Richtung der Schallquelle zu bestimmen. Bei höheren Frequenzen bleiben Unterschiede im Audiopegel wichtig, während die Empfindlichkeit für Phasenunterschiede abnimmt.
Auf dieser Grundlage lässt sich ein Stereo-Audiosignal näherungsweise darstellen, indem ausgewählte höherfrequente Bänder zu einem einzigen Kanal zusammengefasst werden. In den ursprünglichen Kanälen werden dann nur noch Informationen über ihre Amplituden gespeichert. Diese Darstellung benötigt weniger Bits, ist aber grundsätzlich mit gewissen Verlusten verbunden.